O futuro da descoberta de péptidos: automação, síntese e IA
O futuro da descoberta de péptidos não se resume a produzir mais moléculas. Passa por ligar a conceção, a síntese, a medição e a aprendizagem, para que cada experiência melhore a decisão seguinte. A automação e a IA podem reforçar este ciclo, desde que a documentação e a validação experimental acompanhem o ritmo.
Um ciclo de descoberta que aprende
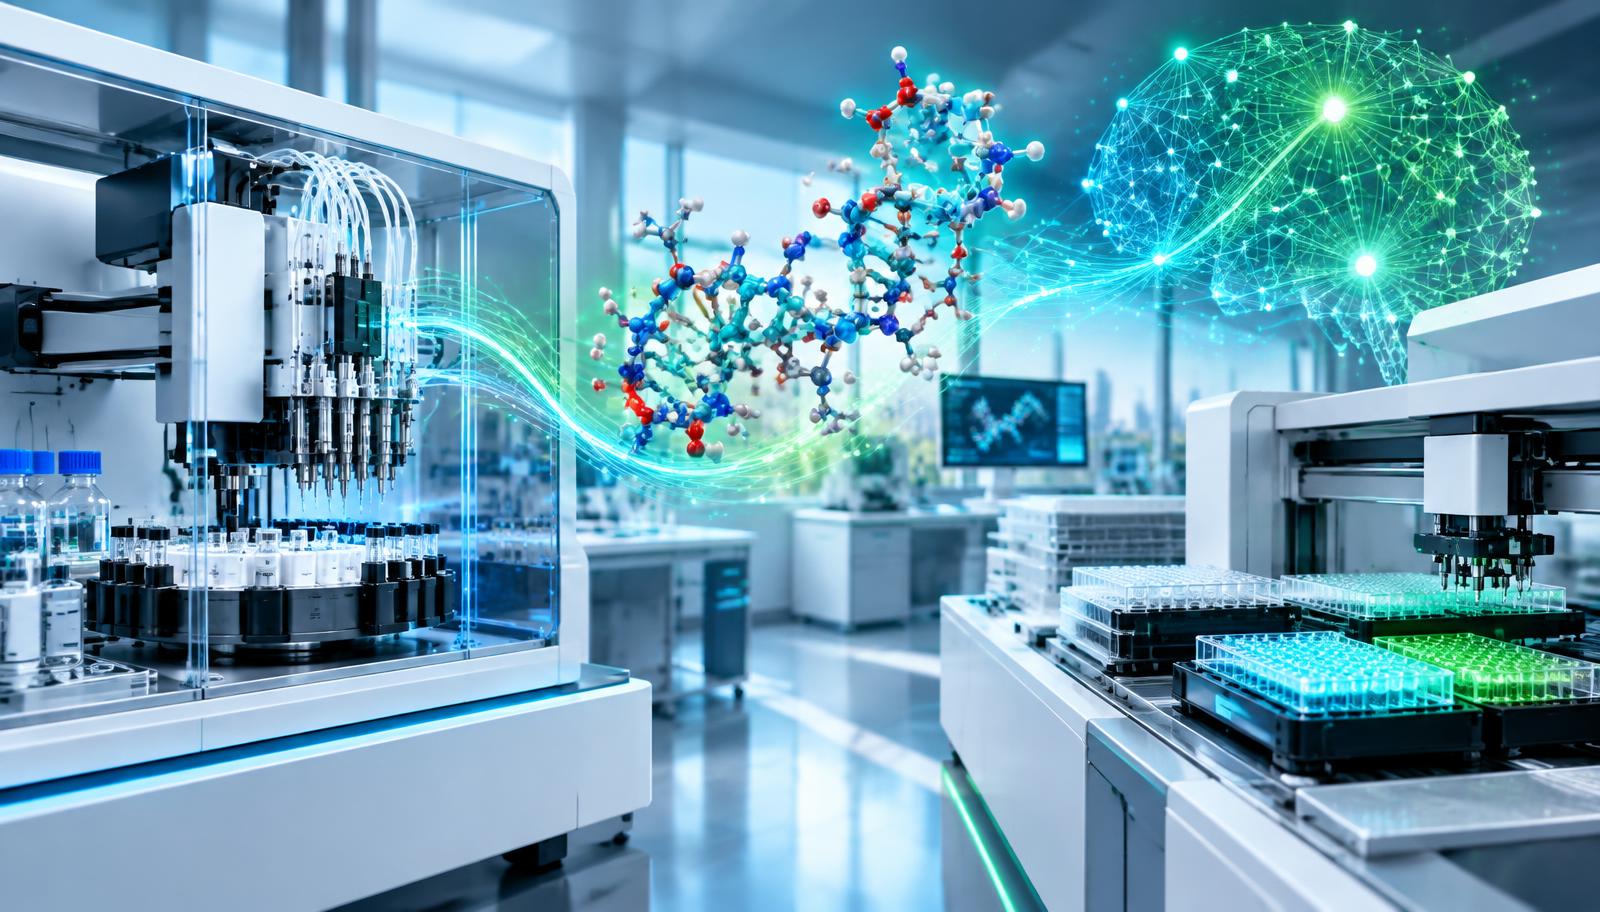
Investigar péptidos implica escolher sequências, decidir que características variar e definir quais as medições capazes de responder à pergunta científica. O ciclo conceber–produzir–testar–aprender organiza estas decisões num processo contínuo. Os investigadores propõem candidatos, produzem amostras, avaliam propriedades relevantes e reformulam as hipóteses com base nos resultados. O principal valor não está numa tecnologia isolada, mas na ligação entre etapas. Aumentar a velocidade de uma operação pouco resolve se a informação obtida não puder orientar a experiência seguinte.
A diversidade dos péptidos abre muitas possibilidades, mas uma proposta molecular interessante pode ser difícil de produzir ou inadequada à pergunta em estudo. É necessário ponderar várias propriedades, em vez de maximizar apenas uma pontuação. A revisão da Nature Reviews Drug Discovery enquadra tendências na descoberta de fármacos peptídicos; neste artigo, o foco é a investigação experimental, não o desempenho clínico. Referência: Nature Reviews Drug Discovery — trends in peptide drug discovery (https://www.nature.com/articles/s41573-020-00135-8).
Ligar a síntese ao rastreio automatizado
A síntese automatizada pode reduzir tarefas repetitivas e facilitar o registo consistente das operações programadas. Quando existe ligação à identificação das amostras e à análise, torna-se também mais simples acompanhar o percurso de cada candidato. Contudo, a automação não elimina as dificuldades químicas. Sequências diferentes podem apresentar desafios distintos de síntese, solubilidade ou purificação. A conclusão de uma execução programada não demonstra, por si só, que se obteve o péptido pretendido com as características necessárias para interpretar um ensaio.
No rastreio, a coordenação entre equipamentos pode apoiar a organização das amostras e a recolha de medições comparáveis. O objetivo é tornar o trabalho mais coerente, não apenas acumular resultados. O estudo citado da Nature Communications aborda a síntese automatizada de péptidos; não deve ser interpretado como demonstração de que qualquer sequência ou tarefa laboratorial dispensa supervisão. Referência: Nature Communications — automated peptide synthesis (https://www.nature.com/articles/s41467-025-62344-2).
- Associar cada resultado à sequência, às modificações químicas e à amostra física efetivamente analisada.
- Manter o histórico da amostra e as verificações analíticas ligados aos resultados de rastreio.
- Tornar visíveis os controlos, as repetições e as ocorrências inesperadas na comparação entre candidatos.
- Distinguir as decisões automatizáveis daquelas que exigem apreciação científica antes de avançar.
O contributo da previsão computacional
Os métodos computacionais podem ajudar a selecionar candidatos antes da síntese. Conforme a pergunta e os dados disponíveis, permitem estimar propriedades, explorar estruturas possíveis ou ordenar sequências para avaliação experimental. A IA procura padrões nos exemplos registados, enquanto outras abordagens recorrem a pressupostos físicos explícitos. São ferramentas complementares, não equivalentes. Prever uma conformação não demonstra necessariamente ligação a um alvo; prever essa ligação também não estabelece um efeito biológico num sistema experimental.
Uma aplicação particularmente interessante consiste em escolher a experiência seguinte pelo conhecimento que pode acrescentar. Na aprendizagem ativa, o modelo incorpora novas medições e propõe candidatos que possam melhorar uma propriedade ou esclarecer uma incerteza. Trata-se de uma estratégia de investigação, não de uma garantia de descoberta. Exige objetivos claros e atenção ao risco de selecionar sempre sequências semelhantes. Por vezes, o candidato mais informativo é aquele que põe os pressupostos à prova, e não aquele que recebe a pontuação mais elevada.
A qualidade dos dados define os limites
Um modelo não corrige de forma fiável registos experimentais ambíguos. A notação da sequência, as modificações, as unidades e o contexto do ensaio influenciam o significado de cada valor. Resultados com a mesma designação podem não ser diretamente comparáveis quando provêm de sistemas diferentes. Sem este contexto, reunir conjuntos de dados pode revelar sobretudo diferenças entre laboratórios, em vez de propriedades dos péptidos. Qualidade significa, por isso, conhecer a origem e a comparabilidade dos dados, e não apenas preencher todos os campos.
A avaliação do modelo deve também corresponder à utilização prevista. Se sequências muito próximas surgirem nos dados de treino e nos de teste, a capacidade de generalização pode parecer superior à real. Candidatos verdadeiramente distintos oferecem uma avaliação mais exigente. Importa ainda registar sínteses mal sucedidas e resultados sem atividade detetada, para evitar uma visão excessivamente favorável. Estes registos precisam de contexto: uma medição inconclusiva não equivale a um resultado negativo confirmado.
Nota editorial: sequências geradas por IA, estruturas previstas e pontuações computacionais são resultados de investigação, não conclusões biológicas validadas. As estimativas de confiança podem falhar perante características químicas pouco representadas no treino. As afirmações devem respeitar os limites da avaliação do modelo e da evidência experimental disponível.
Validar para fechar o ciclo
A validação experimental verifica se uma previsão se sustenta perante uma amostra real e uma medição adequada. Confirmar a identidade e a qualidade analítica apoia a interpretação, mas não demonstra atividade biológica. Esta exige controlos apropriados, avaliação da reprodutibilidade e, quando pertinente, outro método que examine a questão de forma diferente. Caso contrário, um sinal aparente pode resultar de interferência no ensaio. Integrar estas distinções nos dados transforma o teste em aprendizagem. Resultados experimentais não devem ser apresentados como demonstração de benefício em pessoas.
Um futuro mais acessível e bem documentado
O progresso não exige necessariamente laboratórios totalmente autónomos. Convenções de dados partilhadas, equipamentos interoperáveis e modelos bem documentados podem facilitar a participação, embora os custos e a especialização continuem a contar. O desafio é assegurar uma passagem clara de informação entre pessoas, programas e instrumentos, mantendo a responsabilidade científica pela interpretação. A perspetiva otimista é a de experiências mais esclarecedoras, não de certezas automáticas. Para aprofundar estes temas, explore a biblioteca de investigação e o catálogo documentado da Synedica.
Produtos relacionados
Ver tudoPerguntas frequentes
A IA vai substituir os investigadores de péptidos?
Pode apoiar a seleção de candidatos e a identificação de padrões, mas são os investigadores que formulam perguntas relevantes, avaliam limitações e interpretam resultados inesperados. A automação altera a organização do trabalho; não elimina a responsabilidade científica nem o discernimento necessário para perceber o que uma medição demonstra.
A síntese automatizada garante uma amostra adequada?
Não. A automação executa operações definidas, mas o material obtido continua a exigir avaliação analítica apropriada. A química de cada sequência, a purificação e o manuseamento podem influenciar a interpretação. Concluir uma síntese não é o mesmo que confirmar a identidade e a qualidade da amostra utilizada.
Quando é que uma previsão de IA é cientificamente útil?
Quando responde a uma pergunta clara, explicita as suas limitações e pode ser confrontada com experiências. Uma avaliação sem sobreposição com os exemplos de treino e testes de novos candidatos reforçam a evidência. Ainda assim, as conclusões dizem respeito às propriedades e aos sistemas efetivamente estudados.
Fontes e leitura adicional
Sobre o autor
Synedica Research Desk
Equipa de conteúdo científico
A Synedica Research Desk escreve e mantém a biblioteca técnica que sustenta o catálogo da Synedica Europe. A equipa compila literatura publicamente disponível, documentação de fornecedores e dados analíticos em explicações de linguagem simples destinadas a públicos de laboratório e de investigação.
- Reviews certificates of analysis supplied with every Synedica batch
- Sources claims from peer-reviewed literature and regulator publications
- Publishes review dates and correction notes on every article
Continuar a ler
Ver tudo
Da síntese manual às plataformas digitais: a evolução da ciência dos péptidos
A história dos péptidos acompanha mudanças na capacidade de construir moléculas, caracterizá-las e comparar resultados. Entre a química manual e as plataformas digitais, cada avanço abriu novas possibilidades experimentais. Nenhum deles, por si só, eliminou a distância entre investigação laboratorial e validação clínica.

O Que São Péptidos de Investigação? Um Guia Simples
Os péptidos situam-se entre os aminoácidos e as proteínas. Eis o que isso significa na prática, como é produzido o material de grau de investigação e como interpretar o que está impresso no frasco.

Como a Investigação em Péptidos Avança do Laboratório até ao Regulador
Compreender o processo explica por que motivo 'em investigação' e 'aprovado' estão separados por anos e por uma enorme quantidade de evidência.